本篇笔记源自 High Performance Switches and Routers(Chao & Liu) 第 1 章。这一章是全书的地基:它先交代互联网长什么样、路由器长什么样,再说明白为什么“造一台又快又全能的大路由器”这么难。按顺序读下来是三条线:
| 主线 | 教材小节 | 回答的问题 | 优先级 |
|---|---|---|---|
| 网络线 | 1.1 | 互联网是怎么拼起来的?边缘和核心在争什么? | 必读 |
| 设备线 | 1.2 | 一台路由器内部由什么构成? | 核心 |
| 难题线 ★ | 1.4 | 为什么大路由器比光交换机难做得多? | 必读 |
教材剩下的 1.5(网络管理)和 1.6(全书大纲)偏工具性,知道框架即可。
0 所有网络设备本质是同一台机器
讲路由器之前,先交代一件贯穿始终的问题:为什么这本书只讲路由器,却敢说在教“所有网络设备”?
网络里当然不止路由器一种设备:carrier-grade NAT、负载均衡器(load balancer)、DDoS 防护、防火墙(firewall)、入侵检测系统(IDS)、路由器(router)、交换机(switch)。它们表面各司其职,但把外壳剥掉,里面装的是同一台机器。差别只有两处:支持的网络协议不同,支持的线速 / 交换容量不同;其余的都相似:
| 共同点 | 具体表现 |
|---|---|
| 都要处理包头 | 读包头字段、更新包头字段 |
| 都要基于一张表执行动作 | 路由器查路由表,交换机查 MAC 表,防火墙查分类器(classifier) |
| 都是同一套内部架构 | 输入 / 输出、包处理、缓冲、交换 |
读包头 \(\to\) 查表 \(\to\) 执行动作,这是所有网络设备的共同骨架。把路由器吃透,交换机、防火墙、负载均衡器都只是“同一套骨架换一张表”。
而归一的代价也随之而来:既然大家结构相同,大家也就共享同一个难题——如何在高速环境里实现它们。也就是说,“怎么把这件事做快”不是路由器一家的烦恼,而是所有网络设备的共同命题。本书后面每一章,本质上都在回答“这项功能怎么在极短的时间预算里做完”。
1 互联网的架构
你在上海,朋友的服务器在纽约。中间隔了十几家运营商的网络,任何一家都不可能为了连通一个远方节点专门铺一条线——太不划算。所以 ISP(Internet Service Provider) 之间必须互相依托:谁都没有覆盖全程的网络,只能接力——每家把包送到自己的边界,交给下家。这就是互联网的本质——它不是一张网,而是几万张网拼起来的“网的网”(network of networks)。
1.1 ISP 的三个层级
按运营网络的规模,ISP 分成三级,是一个层层转包的关系:
| 层级 | 是谁 | 干什么 | 典型例子 |
|---|---|---|---|
| Tier-1 | 拥有全国 / 全球主干、手握独立国际出口的少数运营商 | 拥有全球高速网络,构成互联网主干;不向任何人买容量,只卖/租给下级 | AT&T、NTT、Lumen、Telia、中国电信、中国联通 |
| Tier-2 | 较大型 ISP | 从 Tier-1 买或租主干接入权,再向下卖 | America Online、Broadwing |
| Tier-3 | 区域服务提供商 | 企业主要通过它们接入互联网 | Verizon、RCN、国内各地有线电视网络公司 |
怎么判断一个 ISP 是不是 Tier-1? 唯一标准是:它是否还需要向别人买 transit。一级的“一级”,不在于它更厉害,而在于它自己就是源头——它不出钱买路。
中国的层级不像美国那么分明。美国是“骨干归骨干、接入归接入”;中国的三大运营商是垂直整合的——既运营全国骨干,又直接做家庭和企业的零售接入。所以一个用户从家里上网到走出国际出口,可能全程都在同一家运营商的网内,中间根本没有“交接”。层级在这里是概念上的划分,不是物理上的边界。
1.2 Peering 与 Transit
这两个词是两种送流量的方式,差别可以逐条对照:
| 方式 | 如何送 |
|---|---|
| Peering(对等互联) | 两家 ISP 开一条直连链路,互相免费转发“发往对方网络的流量”。之所以双方都乐意,是因为交换的流量大致相当——我给你送多少,你也给我送多少,谁都不亏。所以 peering 只在体量相近的 ISP 之间才谈得成。 |
| Transit(转接 / 过境) | 小 ISP 流量太少,跟大 ISP 换不到“平等”,于是花钱买接入整个互联网的资格。小 ISP 付钱给 Tier-1,Tier-1 负责把它送出去到全世界。 |
1.3 POP
POP(Point of Presence,入网点) 是 ISP 在各地设立的物理机房。这里有个最常见的误解:POP 不是路由器,POP 是一间机房。设备住在机房里面,就像柜员在银行里。
所以,接下来不该问“POP 是哪种路由器”,而该问“一间 POP 里放了哪些路由器”。答案是有两种,而且它们的活完全不同。
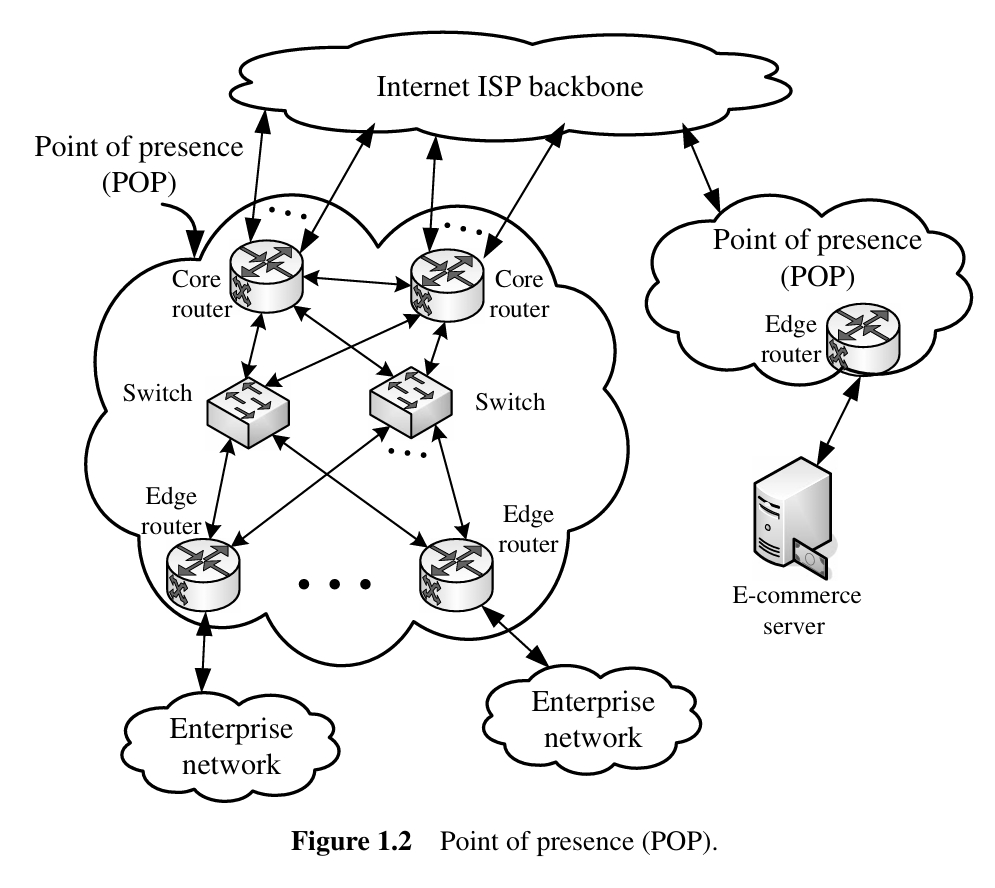
1.4 边缘路由器与主干路由器
一间 POP 里同时住着这两种路由器,一外一内:
边缘路由器(Edge):朝外,接各家企业的细链路;
主干路由器(Core):朝内,连其他 POP、其他 ISP 和互联网主干。
| 边缘路由器(Edge) | 主干/核心路由器(Core) | |
|---|---|---|
| 接的是谁 | 各家企业的细链路 | 其他 POP、其他 ISP、主干 |
| 要求是什么 | 杂:服务种类多、二层协议多 | 快:只管拼命转发 |
| 需求稳定吗 | 宽泛、不断演变 | 定义明确、范围狭窄 |
| 典型速率 | 单条 1.5 Mbps 到多条 155 Mbps | 45 Mbps 到 10 Gbps |
| 二层协议 | 千兆以太网、帧中继等 | IP/MPLS、有时 ATM |
为什么非要分成两种,而不做一台万能机? 因为“杂”和“快”天生矛盾——支持的服务和协议越多,处理逻辑就越复杂,也就越难快;反过来,要做到极致快,就只能把逻辑砍到最简单。历史上正是这两件事没法在一台机器上同时做好,才把它们拆给了两种设备。而让一台路由器同时做到这两点,正是下一代路由器的核心挑战,也是本书后面各章要解决的一串工程问题。
边缘路由器为什么要“聚合”? 企业的连接像一根根细水管——小公司一条 1.5 Mbps 的线,大公司几条 155 Mbps 的线。这些细管子不可能一根根直接接到主干上去。边缘路由器就是个“收纳箱”:把多条细链路接进来,合并成一股粗流量,再统一送给 ISP。这样 ISP 只需要面对几个大口径接口,而不是上百根散户水管。
那客户再多,一台接不下怎么办? 书上说,边缘路由器这时会“被组织成一个池”。这里的池不是水池,而是指一批同规格、同功能的设备放在一起共同分担工作——一台接不下就放好几台,放在一起方便接同一根主干,也方便冗余备份(一台坏了另一台顶上)。就像银行开一排柜台。
注 1
“边缘/主干”是角色,不是位置。本书始终站在 ISP 的视角,所以“边缘路由器”特指 ISP 侧、面向客户的那批(位置在 POP);企业网络自己出口的那台不叫边缘路由器。换个视角(比如从企业看),“边缘”指的又是另一台设备——读到后面章节时,先确认镜头架在哪一边。
注 2:这条分界线是什么时候出现的?
分化约在 1995–2000 年。 在那之前,路由器是“一台通吃”的通用设备;转折点是 Cisco 12000 GSR(1997) 和 Juniper M40(1998)——它们第一次明确“专为骨干设计”,“核心路由器”由此成为一个独立品类。
合并约从 2002 年起。 标志是 Juniper T640(2002)、Cisco CRS-1 与 Juniper TX Matrix(2004) 这类单台容量上 Tb/s 的多机架路由器,也就是下一节要讲的“把路由器做大”。
本书写于 2005–2006 年,正卡在这个转折点上——所以书里说的“未来”,有一部分其实是当时正在发生的事。
1.5 主干网的设计
与 POP 内部结构相对统一不同,主干网的设计因服务提供商而异。书里对比了美国三家的三种范式:
| 提供商 | 主干设计 |
|---|---|
| AT&T | 主要城市设大型 POP,再向外辐射到较小的、按城市划分的 POP,结构是层级/树状的。 |
| Sprint | 只在主要城市设 20 个互联良好的 POP,郊区流量回传(back-haul)到这些 POP 中(经小 ISP 中转)。 |
| Level 3 | 主干通过 MPLS / ATM / 帧中继等电路技术高度互联——这类技术的共同点是先在两端之间建立固定通路、再让流量沿通路走(与逐个包独立选路的纯 IP 转发正好相对);主干与边缘的界限开始模糊,也是下一代网络设计的方向。 |
2 未来向哪走
本节会用到三个名词:
- OXC(Optical Cross-Connect,光交叉连接):光层的“接线板”——把输入光纤直接接到输出光纤,全程不把光转成电。
- DWDM(Dense Wavelength Division Multiplexing,密集波分复用):一根光纤里并行跑多路不同波长的光,相当于把单车道变成几十车道。
- MPLS(Multiprotocol Label Switching,多协议标签交换):给数据包贴一个短标签,沿途路由器只看标签转发,不再逐个查 IP 地址,因此比纯 IP 转发快。
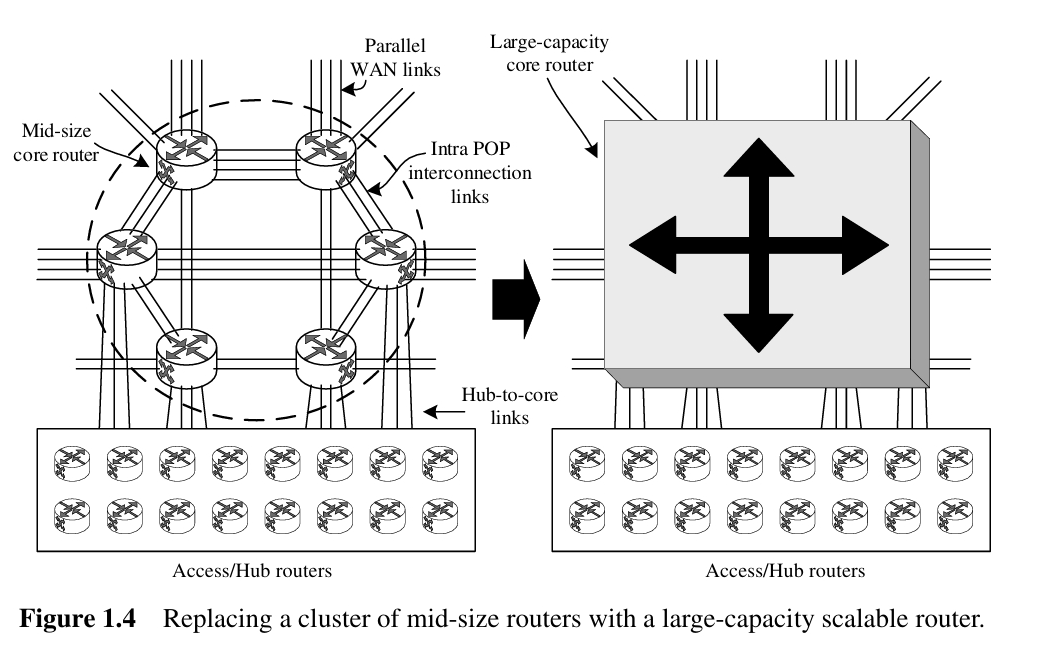
下一代路由器要想同时做到“杂”和“快”,方向有两种:把 IP 路由器本身做大,一台就扛下整个 POP 的流量;或者把交换交给光设备——IP 路由器只管接入,中间的转发由光设备完成。
两条路谁走得通,很大程度取决于成本。而光传输和光交换设备的价格急剧下降,天平一下子偏向了后者,于是不少设计者提出:边缘放中等规模的 IP 路由器 / MPLS 交换机,各自接到 OXC,OXC 之间再用 DWDM 互联——光既然便宜了,就让光自己去切。
但它有一个绕不过去的矛盾。关键前提是:接 OXC 的链路速率极高(当时 10 Gbps,不久 40 Gbps)。设想 5 台边缘路由器 A~E 挂在同一台 OXC 上,而它们要能互相通信——有两种连法,都不好:
| 做法 | 好处 | 代价 | |
|---|---|---|---|
| 直连 | 给每个目标单独铺一条专用线 | 只跳一次,时延低 | 每条线大部分时间空着,利用率低 |
| 绕路 | 共用一条线、经中间路由器中转 | 线路满载,利用率高 | 多跳几次,时延高 |
要利用率就得绕路,要低时延就得直连,鱼与熊掌不可兼得。根本原因在于“管道太粗”:如果是 100 Mbps 的细线,空闲一点无所谓;正因为是 10/40 Gbps 的巨管,直连的浪费才格外刺眼。既然这条路走不通,本书偏向另一条:在 POP 处构建规模庞大的 IP 路由器,把边缘流量汇聚成高速链路,再经 DWDM 直接连到别的 POP。好处是利用率高、跳数少、时延低。于是 OXC 的角色被降级——不再用于动态切换,而只用于预置(provisioning,提前搭好光路)和恢复(restoring,故障时切备用路)。
但市面上还没有能扛下整个 POP 的路由器。于是通行做法是:把若干台中等规模核心路由器用大量链路互联成集群,但这样链路和接口板卡(线卡,即路由器上承载网络接口的板卡)大多用在了集群内部互通上,而非承载真正挣钱的用户流量,是纯粹的浪费。所以,更好的做法是:用一台大容量、可扩展的路由器替换掉整个集群——省钱、不必频繁换代、需要管理的设备也更少。注意:“一台”可以是逻辑意义上的,而不是物理意义上的。
3 路由器架构
路由器的功能可以用一句话概括:把到达某条输入链路的分组,转发到查表所决定的输出链路上。围绕这句话,剩下全是工程问题:转发决策由谁来做、决策要用的表存放在哪里、分组在途中哪一段被缓冲。本节按「整机 → 分界 → 分界如何落到硬件 → 两侧各自的细节 → 部件 → 扩展」的顺序展开。
3.1 一台路由器的整机结构
1 | ┌────────────┐ ┌────────────┐ ┌────────────┐ |
一台路由器由三部分构成:线卡(line card)、交换结构(switch fabric)与控制器。这三部分恰好对应路由器要做的三件事:
| 功能 | 由谁完成 | 含义 |
|---|---|---|
| 路由(routing) | RC 与路由协议 | 在网络拓扑的尺度上决定「去往某网络该走哪条路」,运行在控制通路,不逐包执行 |
| 交换(switching) | 交换结构 | 把分组从一块线卡搬运到另一块线卡 |
| 转发(forwarding) | 线卡上的转发引擎 | 对每个分组逐包查表、改写头部、决定输出端口 |
线卡有两个身份:它既是数据进出路由器的出入口,又为物理层与上层协议提供通向交换结构的接口。因此每块线卡在网络侧至少需要一条全双工光纤连接,在交换结构侧至少需要一条输入(ingress)连接和一条输出(egress)连接。
RC 与 MC 同线卡之间的通信,既可以经过交换结构,也可以经过一条独立的互联网络(例如一台以太网交换机)。后者的好处是把控制通路的流量与用户流量分开:管理报文不会被拥塞的用户流量挤掉,路由协议的收敛过程也就不受转发负载影响。
在 2.5 Gbps 及以上的接口上,线卡还要额外承担两件事:网络侧支持信道化(channelization),把若干条低速线路聚合成一条逻辑上的大管道;交换结构侧提供流控(flow control)机制,用成千上万个输入 / 输出队列调节进出交换结构的流量。这些队列正是虚拟输出队列(VOQ, virtual output queue)的雏形,用来消解交换结构入口之间的竞争,教材的后续章节会详细展开。
3.2 数据通路与控制通路
路由器的一切功能可以劈成两半,这是理解整机结构的前提:
| 数据通路(datapath) | 控制通路(control plane) | |
|---|---|---|
| 执行频率 | 每一个经过的分组都要执行 | 相对不常执行 |
| 具体内容 | 转发决策、经背板转发、输出链路调度 | 系统配置、管理、路由表信息交换 |
| 速度约束 | 极严,必须跟上线速 | 不严格 |
| 实现方式 | 硬件(ASIC / NP) | 一般用软件即可 |
这条线之所以关键,在于「每个分组都要做」与「偶尔做一次」的成本相差若干数量级:前者被线速直接约束,必须固化成专用硬件并精简到极致;后者可以慢慢算,用通用处理器和软件实现。本书后续所有设计,都是在这条分界线的两侧分别做文章——把数据通路做快,把控制通路做灵活。
3.3 路由器结构演进
既然控制通路的活不常干、数据通路的活必须极快,一个自然的追问是:转发引擎该放在哪里? 这个问题没有唯一答案,历史上给出的三种答案,正好对应三代路由器结构。
低端路由器:集中在中央。 中央有一块 CPU 和一块内存,路由表与分组缓冲区都放在这里;线卡上只有物理层与 MAC。每个分组都要经共享背板(shared backplane)送到中央处理再送回去。这种结构的转发能力同时受制于 CPU 的处理速度和共享总线的带宽,只适用于接入侧。
中端路由器:把缓存下放。 线卡上增加了本地缓冲、内存和一张转发缓存(forwarding cache)。命中缓存的流由线卡直接转发,不必再打扰中央;只有未命中的流才上送 CPU 处理,结果写回缓存。背板仍是共享的,因此总线带宽依然是天花板,但中央 CPU 已不再是瓶颈。
高端路由器:把转发整体下放。 背板换成交换式背板(switched backplane),典型实现是交叉开关(crossbar),多对输入输出可以同时传送;每块线卡持有转发表的完整副本和本地缓冲,分组在线卡之间经交换结构直接转发,CPU 退出逐包路径,只负责跑路由协议并把转发表下发到各线卡。
| 低端 | 中端 | 高端 | |
|---|---|---|---|
| 转发决策与依据 | 中央 CPU 用软件查中央内存中的路由表 | 线卡查转发缓存——转发表的子集,未命中才上送中央 CPU | 线卡上的转发引擎查本地的转发表完整副本,不存在未命中 |
| 缓冲区 | 中央共享 | 线卡本地 + 中央 | 每块线卡本地 |
| 背板 | 共享背板(总线) | 共享背板(总线) | 交换式背板 |
| 典型位置 | 接入侧 | 企业汇聚 | 核心 |
表中三处容易一带而过的差别:
「缓存」与「副本」不是一回事,这是中端与高端的分水岭。缓存只是转发表的一个子集,按需填充:某条流的第一分组查不到,被上送中央 CPU,CPU 算出结果后写回该线卡;此后这条流的分组命中缓存,由线卡直接转发。副本则是由 RC 下发到每块线卡的整张表,每个分组都命中。这个区别在流量分布接近均匀时会暴露出来:缓存的命中率依赖流量局部性,一旦命中率崩塌,分组又全部涌向中央 CPU,中央重新成为瓶颈;完整副本给出的是可预测的最坏情况性能——代价是每块线卡都要有足够内存容纳整张表,且每次更新都要下发到所有线卡。核心路由器宁付这个代价,是为了不赌流量分布。
缓冲区是分组的排队场所,承担三件事:其一,多个输入端口同时要往同一个输出端口发送时,一条输出链路一个时刻只能发送一个分组,其余的分组必须有地方等待;其二,统计复用下某个输出口的瞬时到达速率会超过链路速率,缓冲把突发存下来慢慢发出以免丢包;其三,分组是线速到达的,而查表、改写头部、等待交换结构授权都需要时间,分组必须在本地先被存住。缓冲区同时也是 QoS 的执行地点——丢弃哪个分组、先发送哪个,都是在这里决策的。代价是排队越长时延越大,因此缓冲区并非越大越好。
背板是机箱后部把所有板卡连起来的连接平面,可以理解成机箱的「母板」:每块线卡插在其上,分组从一块线卡经它到达另一块线卡,控制通路的流量也走它。两种背板的差别只有一个:同一时刻能容纳几对线卡通信。共享背板是一条总线、所有线卡共用,同一时刻只能有一对线卡在传输——A 发给 B 的时候 C 不能发给 D,因此总容量被总线带宽锁死,与插入多少块线卡无关;交换式背板内嵌一台真正的交换开关(典型实现是交叉开关),可以同时建立多条并行的输入到输出通路,容量随端口数增长。从「一条共用的路」变成「一个有开关的路网」,正是高端路由器得以为高端的原因。
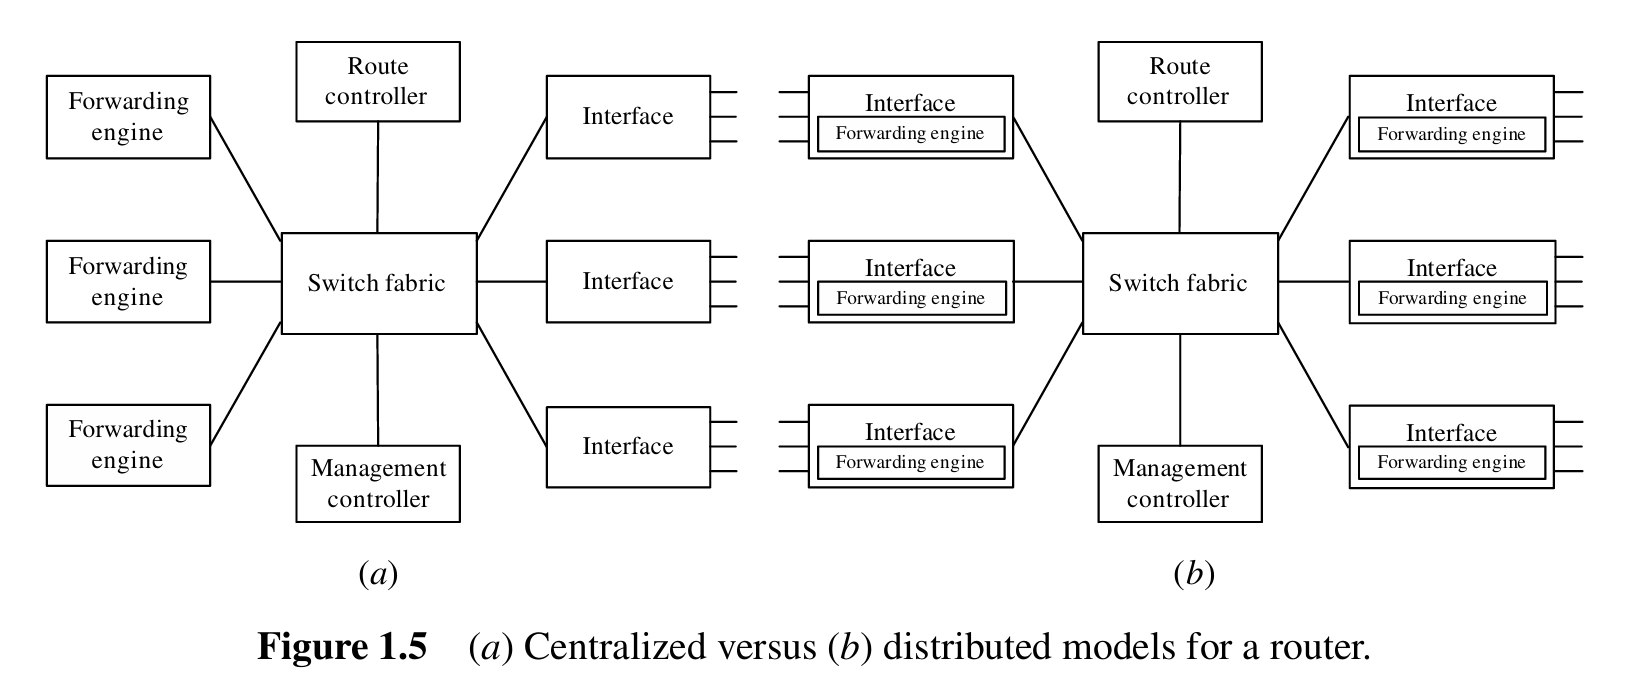
三代结构的演进主线只有一条:把转发决策从中央推向边缘,直到 CPU 完全退出逐包路径。教材把这一演进的两种形态归纳为集中式与分布式:
- 集中式:转发引擎是共享的,被所有接口共用。输入接口把报文头(不是整个分组)经交换结构送给转发引擎,引擎决定该分组应送往哪个输出接口,再把结果回传给输入接口,由后者转发。引擎的唯一任务是处理报文头,其余任务(参与路由协议、预留资源、处理需要额外关照的分组、管理维护)全部交给 RC 与 MC。
- 分布式:把转发引擎的功能整合进接口卡本身。每个接口自己就能决定分组往哪里走,不必所有分组都去问同一个共享引擎,因而速度快得多。RC 的职责相应地变成:维护路由表 → 生成转发表 → 下载到各接口卡中的转发引擎。目前的高性能路由器几乎都采用这一模型,也就是上一节所说的第三代结构。
3.4 数据通路:一个分组要经过哪些处理
分组进入转发引擎后,数据通路执行四个动作:
取出网络部分:用子网掩码对目的 IP 地址做逻辑与(AND)运算。
查表选路:用结果查转发表,按最长前缀匹配(LPM, longest prefix matching)确定输出端口。之所以强调「最长」,是因为前缀之间存在包含关系——例如
128.9.16/20的地址空间完全落在128.9/16之内,此时更具体的128.9.16/20才是正确结果。如何在极短时间内完成这一步,是第 2 章的主题。分组分类:在需要区分服务的场景下,用五元组对分组做分类,据以决定丢弃(防火墙)或按不同优先级处理。这是一个多维匹配问题,难度高于单维的前缀匹配,是第 3 章的主题。
改写头部:TTL 减一,并重新计算报文头校验和。
五元组(5-tuple):IP 源地址、IP 目的地址、传输层源端口号、传输层目的端口号、协议类型。这五个字段是识别「一条连接」的最小集合,防火墙、QoS 分类与连接跟踪都建立在它之上。
除上述处理外,每个端口还配有缓冲管理器(buffer manager)和缓冲内存,用于在输出竞争时暂存分组并决定去留。缓冲区放在哪里、如何调度,决定了交换机的可扩展性与性能,是第 4、5 章的主题。
这四个动作有一个共同的约束:它们必须在「一个分组到达与下一个分组到达」之间的时间预算内全部完成。下一节将说明,当线速提高时,这个预算如何被压缩到纳秒量级。
3.5 控制通路:路由协议与两张表
控制通路的核心工作是运行路由协议,并据此维护转发表。三种典型协议:
| 协议 | 机制与特点 | 适用场景 |
|---|---|---|
| RIP(Routing Information Protocol) | 距离向量:每个路由器定期把自己的整张路由表告诉邻居,逐跳传播;以跳数为度量,实现简单,但收敛慢、规模有限 | 小型网络 |
| OSPF(Open Shortest Path First) | 链路状态:先让域内每台路由器都掌握同一张完整拓扑图,再各自独立计算最短路径;收敛快,可分层 | 域内(同一自治系统内部) |
| BGP(Border Gateway Protocol) | 路径向量:交换的是到达某个网络的完整 AS 路径,据此按策略而非单纯最短来选路,是 ISP 之间互通的基础 | 域间(ISP 之间) |
路由协议就是算路的算法吗? 不完全是。协议是一整套路由器之间如何协商路由的规则,算法只是其中的一环:
- 信息交换:邻居之间发什么消息(OSPF 发链路状态通告,BGP 发路由通告);
- 路径算法:OSPF 用 Dijkstra 最短路径算法,RIP 用 Bellman-Ford 算法;
- 配套机制:定时器、故障检测、收敛行为等。
即:协议 = 算法 + 通信规则 + 定时器。
控制通路要维护两张表,它们的分工是本节最容易被含糊带过的地方:
1 | 路由协议(OSPF / BGP,路由器之间协商) |
| 路由表 | 转发表 | |
|---|---|---|
| 位置 | RC | 线卡 / 转发引擎 |
| 优化目标 | 快速更新(路由协议在不断修改它) | 快速查找(每个分组都要查一次) |
| 是否动态 | 动态 | 不必动态 |
为什么要拆成两张表? 因为同一份信息面对两种相互冲突的需求。一方面,路由更新可能很频繁,路由表必须易于修改,且便于按前缀组织和增删;另一方面,转发引擎要在纳秒级完成查找,转发表必须按硬件查找的特点重新组织(例如组织成便于逐位下行的树结构)。把两种需求放在一张表上,只会两边都做不好。
为什么不必每次路由更新都下发新转发表? 因为路由协议需要数量级为分钟的时间才能收敛(converge),即全网对拓扑达成一致。在这之前下发转发表,转发依据本身就是不稳定的。因此 RC 会等路由表稳定后再生成并下发,而不是每收到一条更新就动一次线卡。
3.6 控制通路的两个角色:RC 与 MC
| RC(route controller,路由控制器) | MC(management controller,管理控制器) | |
|---|---|---|
| 管什么 | 分组怎么到达目的地 | 设备怎么运营和维护 |
| 做什么 | 跑路由协议、维护路由表、生成并下发转发表 | 配置参数、监控状态、告警、日志、统计 |
| 面向 | 网络拓扑的变化 | 管理员与运维流程 |
MC 的具体职责包括:配置(接口参数、端口启停、QoS 策略)、监控与告警(线卡健康、链路故障)、管理接口(CLI、SNMP 等远程入口)、统计与日志,以及软件升级与资产管理。
3.7 线卡的五个组件
一块线卡通常包含五个组件,它们构成一条从「光进门」到「送进交换结构」的流水线:
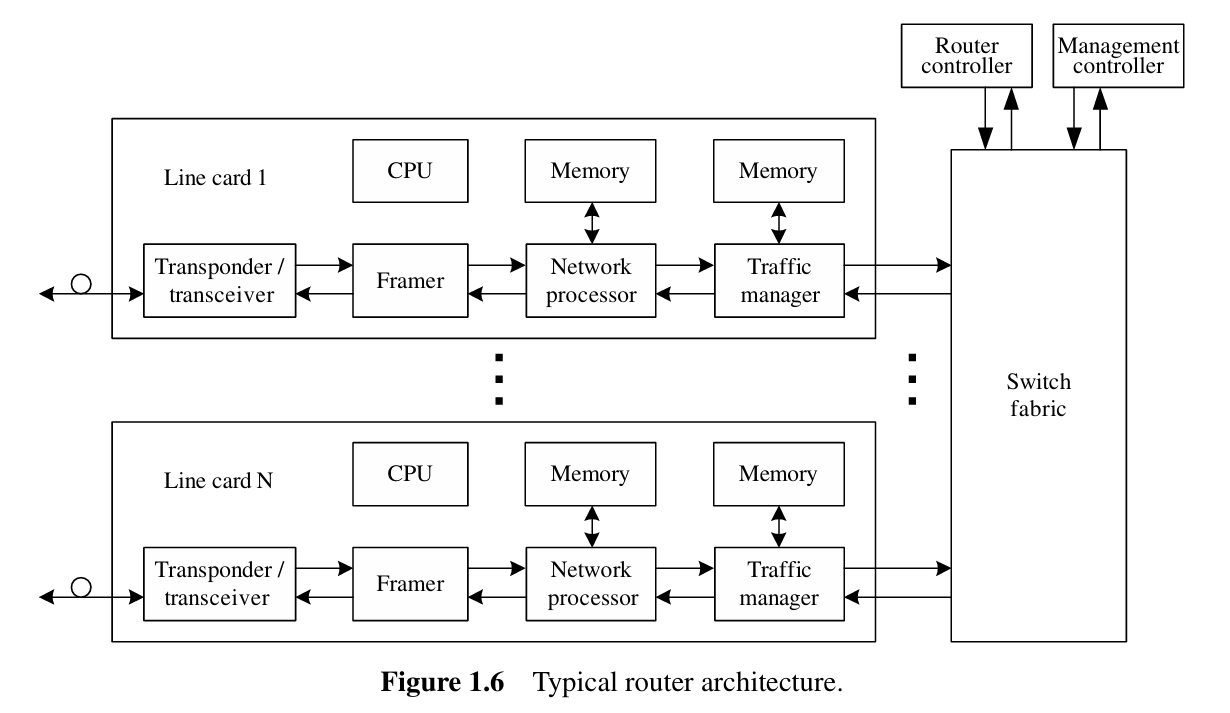
1. Transponder / Transceiver(应答器 / 收发器):完成光 \(\leftrightarrow\) 电信号转换与串行 \(\leftrightarrow\) 并行转换。它是「光世界的边界」,越过它之后,一切都在电域处理。
2. Framer(成帧器):执行同步、帧开销处理、信元 / 分组定界。以 SONET/SDH 成帧器为例,发送侧生成 section(段)/ line(线路)/ path(通路)三层开销,插入帧图案 A1、A2,做加扰,并生成 B1/B2/B3 比特交织奇偶校验供对端做性能监测;接收侧做对应的开销处理、帧定界、解扰、告警检测与指针解释,并累计 B1/B2/B3 的校验错误。以太网成帧器是它的替代方案。
3. Network Processor(NP,网络处理器):做表查找(见第 2 章)、分组分类(见第 3 章)与数据包修改。前两项可借助外部 SRAM / DRAM 在线速下完成;若需要更高层次的深度分组分类,还要借助外部 CAM 或专用协处理器。
4. Traffic Manager(TM,流量管理器):QoS 的执行者,承担三类功能。
- 流量接入控制(traffic access control):在入口管住流量,分三步:规定(specify)数据流的流量特性与服务需求(峰值速率、时延界限、丢包容限);整形(shape),通过延迟降低其速率与突发性;监管(police),在流量偏离规格时采取纠正措施(丢弃、延迟或标记)。
- 缓冲区管理(buffer management):缓冲区超过阈值时,按丢包需求与优先级丢包。方案包括 EPD(早期分组丢弃)、REPD(随机早期分组丢弃)、WREPD(加权随机早期分组丢弃)与 PPD(部分分组丢弃)。
- 分组调度(packet scheduling):确保各连接拿到约定的带宽与时延。方案包括赤字轮询(deficit round-robin)、WFQ(加权公平排队)及其变体整形虚拟时钟与 WF²Q+,后两者可实现最坏情况公平性。
TM 还可能管理成百上千个队列(即 VOQ,virtual output queue)以消解交换结构入口之间的竞争。
5. CPU(中央处理器):连接建立与拆除、表更新、寄存器与缓冲区管理、异常处理,不在快速通路上。
4 核心路由器的设计
核心路由器的使命是尽可能快地转发流量。但随着边缘服务多样化、带宽需求暴涨,光“快”已经不够了。
4.1 七类设计目标
| # | 目标 | 具体含义 | 关键数字 / 例 |
|---|---|---|---|
| 1 | 分组转发性能 | 每秒转发数亿个分组 | 支撑现有服务 + 未来增长 + 新创收服务 |
| 2 | 可扩展性 | 设备寿命要长,升级要便宜 | 业界原本 3–5 年换一次设备;新设计成路由矩阵,保留现有基础设施即可加带宽;统一软件镜像让用户不用重新培训 |
| 3 | 带宽密度 | 小空间塞大带宽,省电省地 | 半机架内提供 32 个 10 Gbps 口,或 128 个 2.5 Gbps 口 |
| 4 | 服务交付特性 | 高速下仍能提供各种服务 | 聚合 DiffServ 等级、分组过滤、监管、限速、流量监控——且不能拖累转发性能 |
| 5 | 可用性 | 高流量和维护期间都不能挂 | 冗余 + 热插拔硬件、模块化软件;支持在线换硬件、升级软件 |
| 6 | 安全性 | 抵御攻击 + 支持边缘安全 | 抗 DoS;提供限速、过滤、追踪、日志 |
4.2 六大设计挑战
(1) 内存速度
推导链是这样的:
目前光电器件跑 400 Gbps,800 Gbps 正在规模化;
交换结构的端口速度 = 线路速度 \(\times\) 2(这里 2 是工程余量,不是物理规律,为了克服输出端口竞争、承载路由/流控/QoS 信息的报文头开销,在第 5 章会展开讨论);
于是现在 800 Gbps 的以太网的端口内部速率是 1.6 Tbps;
以 40 字节的包计算,每个端口缓冲内存的周期时间要求 \(<\) 0.2 ns。
走到第 4 步,这条推导其实已经作废了——0.2 ns 意味着存储器要跑 5 GHz 的读写周期。没有任何一种存储器能满足 0.2 ns。所以今天不是「用更快的内存去满足这个周期」,而是把这个周期拆给很多块并行工作的存储器。
(2) 分组仲裁
什么是仲裁:多个输入端口同时想往同一个输出端口发包,但一条输出链路一个时刻只能传一个包。谁先谁后,必须由仲裁器(arbitrator)来定。
难在哪:800 Gbps 端口 + 40 字节包 + 2 倍加速 → 仲裁器只有约 0.2 ns 拍板(这个量级同样只能靠并行化解,见 (1));输入端口越多,消解竞争的时间越短。两种实现各有代价:
| 集中式 | 分布式 | |
|---|---|---|
| 做法 | 一个中央仲裁器 | 线卡 + 交换卡共同参与 |
| 问题 | 仲裁器与所有输入端口的互联复杂且昂贵 | 信息不全(拿不到所有输入输出的状态)→ 降低吞吐和时延 → 需要更高加速比来补偿 |
(3) QoS 控制
与仲裁同源:线速越快,决策时间越少。输入端口要执行监管/整形,输出端口要执行分组调度 + 缓冲区管理,都要满足每条流 / 每个等级的 QoS。
每块线卡缓冲区通常要装约 100 ms 的数据;
800 Gbps 线路 → 缓冲区可达 10 GB(能存数百万个包);
要在 0.2–0.4 ns 内决定“哪个包出发、哪个包丢弃”;
逐流(per-flow)控制需要维护的状态数量多到难以承受。
所以出路是改用基于等级(class-based)的调度和缓冲区管理——在核心网更合理,因为核心网的流数量和链路速度都太高了,没法逐流管理。还有一个隐性瓶颈:某些整形/调度方案要求给到达包打时间戳,再按时间戳排出发顺序。要在 0.2–0.4 ns 内选出时间戳最小的包,本身就会成为瓶颈。
(4) 光互联
大容量路由器要跨多个机架(线卡、端口卡、交换结构卡、控制器卡),机架之间只能靠光互联。它带来四类麻烦:光器件的尺寸与功耗限制每块板能引出的互联数量 \(\to\) 电路板变多、成本上升;机架间要铺大量光纤 \(\to\) 安装贵,重配置和维护难;布线稍有不慎就会因人为差错中断;扩容加光纤易出错,还会干扰现有服务。
(5) 功耗
高速串行与光互联是功耗大户。
(6) 灵活性
核心路由器正在向网络边缘靠近,于是不得不支持边缘那些五花八门的协议和服务。这就要求路由器设计必须模块化、能随未来需求演进。结论是:不能过分依赖快速的 ASIC 操作,而要在性能与灵活性之间取得平衡——方法是采用可编程 ASIC。
- ASIC(专用集成电路):为某功能专门造的芯片,快但不易改;可编程 ASIC 则是兼顾速度与可配置性的折中。